 Anbieter wie Microsoft Bing, Open AI etc. reagieren auf die zunehmenden Probleme mit ihrem Ansatz, Webseiteninhalte durch AI-Modelle abzuschöpfen (Web-Scraping). Die Anbieter wollen Webseitenbetreibern leichtere Opt-out-Möglichkeiten gewähren, das Web-Scraping zu sperren, ohne dass die Indizierung der Seiteninhalte durch die KI-Modelle negativ beeinflusst wird. Die Information ist mir bereits am Wochenende untergekommen.
Rückblick auf zwei Ereignisse in voriger Woche
KI-Bots, die das Web nach Inhalten abgrasen und diese dann für AI-Angebote abziehen (scrapen) gefährden langfristig den Bestand des Internets. Das wurde zum 29. Oktober an zwei Nachrichten deutlich.
reddit geht hinter Anmeldeschranke
Einmal wurde zum 29. Oktober 2026 bekannt, dass Reddit seine Inhalte nur noch für angemeldete Benutzer bereitstellen wird (Axios hat es in diesem Beitrag angesprochen). Steve Huffman, Mitbegründer und CEO von Reddit, erklärte in einem Interview, dass das Unternehmen diese Änderung vornehme, um die Nutzererfahrung zu verbessern, das Anzeigengeschäft zu stärken und Bots daran zu hindern, seine proprietären Daten zu scrapen. Denn das Problem ist, dass reddit.com immer mehr Nutzer durch Inhalte, die durch Bots und AI-Agenten abgegriffen werden, verloren gehen. Das gefährdet letztendlich die Monetarisierung der Plattform. Direkt-Links, die in Beiträgen gesetzt werden, sollen wohl weiterhin ohne Benutzeranmeldung angezeigt werden. So will man den KI-Bots etwas gegenüber setzen.
Google hat sein Anzeigengeschäft ruiniert
Dann hatte ich zum 29. Oktober 2026 im Blog-Beitrag Quartalsumsätze bei Microsoft, Aktieneinbruch bei Google, KI-(Finanz-)Sorgen steigen den dramatischen Kurssturz beim Alphabet Aktienkurs angesprochen. Binnen kurzer Zeit verringerte sich der Alphabet-Aktienkurs um die 520 Milliarden US-Dollar.
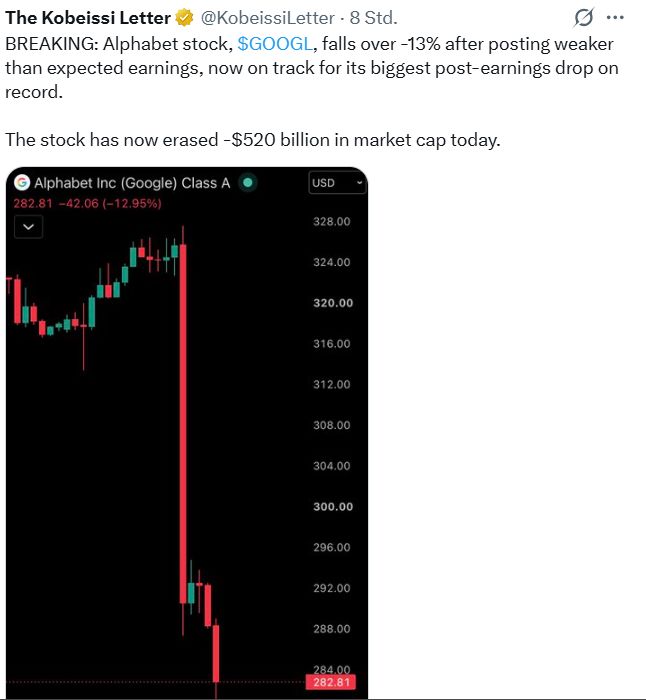
Hintergrund für den Kurssturz ist, dass die Einnahmen des Google Werbegeschäfts unter Druck stehen (die BBC berichtete). Alphabet hatte bekannt gegeben, dass seine KI-Zusammenfassungen in der Suche die Werbeeinnahmen beeinträchtigten.
Big AI-Tech-Firmen reagieren
Sowohl Microsoft mit Bing, als auch OpenAI und Google reagierten vergangene Woche und haben entsprechende Erklärungen veröffentlicht, nach denen Inhaber von Webseiten leichter entscheiden könnten, ob sie die Inhalte von Webseiten von AI-Bots scrapen lassen wollen.
Die großen KI-Anbieter OpenAI, Google, Microsoft und Anthropic wollen einen neuen Standard einführen, mit dem Publisher verhindern können, dass ihre Inhalte von KI-Systemen „gescrapt“ werden. Das berichtet Search Engine Roundtable in diesem Artikel.
Google, Bing, OpenAI und Anthropic haben angekündigt, einen Vorschlag freiwillig umzusetzen, der derzeit bei der IETF, der globalen Organisation zur Festlegung von Internetstandards, geprüft wird. Der Vorschlag soll eine einfache, optimierte Kontrollmöglichkeit für das Training von KI für Web-Publisher und Content-Ersteller schaffen.
Das gemeinsame „Policy-Token“-Signal wurde von Kevin Kelley, einem technischen Leiter für Standards bei Anthropic, im Rahmen der Internet Engineering Task Force (IETF) vorgeschlagen. Es soll in der robots.txt-Datei einer Website hinterlegt werden. Dort können Webseitenbetreiber seit langem signalisieren, welche Webcrawler eine Website scrapen dürfen und welche nicht. Das gilt für die Suchindexierung, die Archivierung oder das Training von KI. Derzeit müssen Websites ihre Präferenzen für das KI-Training jedem KI-Unternehmen separat mitteilen. Nun sollen Publisher ihre Präferenzen für das Training von KI-Systemen für mehrere KI-Unternehmen einheitlich festlegen können.